Masalahnya Bukan Kehilangan, Tapi Terlambat Menyadari
Di banyak operasional last-mile, kehilangan paket hampir selalu diperlakukan sebagai sebuah kejadian atau sesuatu yang “terjadi” di titik tertentu, lalu perlu diinvestigasi.
Biasanya prosesnya seperti ini:
Paket dinyatakan hilang → Dilakukan tracing → Dicari siapa yang terakhir memegang.
Pendekatan ini tidak sepenuhnya salah, tapi ada satu hal yang sering terlewat.
Dalam banyak kasus, paket sebenarnya sudah “hilang” jauh sebelum statusnya berubah menjadi lost.
Ia mungkin:
- Berhenti/Stuck terlalu lama di satu area
- Tidak ter-scan di checkpoint tertentu
- Keluar dari flow normal tanpa terdeteksi
Masalah utamanya bukan kehilangan itu sendiri, melainkan keterlambatan sistem dalam menyadari bahwa sesuatu sudah tidak normal.
Di sinilah perbedaan antara sekadar menjalankan operasional dan benar-benar mendesain sistem.
Melihat Kehilangan sebagai Flow Failure, Bukan Incident
Ketika kita melihat kehilangan sebagai sebuah incident, fokus kita akan selalu berada di belakang untuk mencari apa yang sudah terjadi.
Namun ketika kita melihatnya sebagai bagian dari flow, pertanyaannya berubah, “Di mana paket keluar dari sistem tanpa terdeteksi?”
Dalam sistem yang sehat, setiap paket selalu berada dalam state yang jelas. Ia berpindah dari satu proses ke proses berikutnya tanpa “ruang abu-abu”.
Masalah mulai muncul ketika ada gap kecil yang dianggap normal, diantaranya:
- Jeda antar proses terlalu panjang
- Perpindahan tidak tercatat dengan baik
- Tidak ada validasi di titik tertentu
Dalam menangani salah satu operasional last-mile, saya menemukan bahwa sebagian besar paket yang pada akhirnya dikategorikan sebagai hilang sebenarnya sudah menunjukkan pola deviasi sejak awal. Hanya saja tidak pernah dianggap sebagai masalah.
Artinya, sistem tidak gagal di akhir. Sistem gagal sejak awal, tapi tidak ada yang menyadari nya.
Checkpoint Bukan Sekadar Tracking, Tapi Titik Kontrol
Banyak operasional merasa sudah memiliki sistem yang baik karena setiap pergerakan paket tercatat. Dashboard terlihat lengkap, data tersedia, dan histori paket bisa ditelusuri.
Namun dalam praktiknya, paket tetap bisa “menghilang” di dalam sistem yang terlihat rapi tersebut.
Masalahnya sederhana, yaitu checkpoint digunakan sebagai pencatatan, bukan sebagai control.
Setiap checkpoint seharusnya memiliki fungsi yang jelas.
Disini, checkpoint harus memastikan bahwa paket benar-benar melewati proses tertentu, bukan hanya tercatat pernah ada di sana. Checkpoint juga harus membatasi berapa lama paket boleh berada di titik tersebut.
Dan yang tidak kalah penting, harus ada kejelasan siapa yang bertanggung jawab di fase itu.
Tanpa tiga hal ini, tracking hanya menjadi catatan historis yang hanya memberi visibilitas, tapi tidak memberi kendali.
Time Threshold: Mengubah Delay Menjadi Sinyal Dini
Salah satu perubahan paling sederhana namun berdampak besar dalam system design adalah mendefinisikan batas waktu untuk setiap proses.
Tanpa batas waktu, semua delay terlihat “normal”. Namun, dengan batas waktu, delay berubah menjadi “sinyal”.
Dalam praktiknya, tidak perlu langsung kompleks. Cukup mulai dengan pendekatan sederhana.
Misalnya, sorting tidak boleh lebih dari 3 jam, bagging tidak boleh tertunda terlalu lama, dan delivery memiliki batas waktu yang jelas. Semua harus diatur dalam lead time tertentu.
Dalam satu fase implementasi, ketika paket yang berada terlalu lama di area sorting dapat ditandai sebagai at-risk. Yang artinya, paket tersebut memasuki fase anomali.
Paket-paket ini belum hilang, tapi memiliki pola yang sama dengan paket yang akhirnya hilang di masa lalu.
Perbedaannya, kali ini sistem menyadarinya lebih cepat.
Dari sini, tindakan bisa dilakukan sebelum masalah benar-benar terjadi.
Fokus pada yang Tidak Normal, Bukan Semua Data
Seiring skala operasional bertambah, jumlah data akan meningkat secara eksponensial. Pada titik tertentu, memantau semua hal justru membuat tim kehilangan fokus.
Di awal implementasi, sering kali tim mencoba melihat semuanya. Melihat setiap pergerakan, setiap laporan, setiap angka.
Hasilnya hampir selalu sama, yaitu banyak data, sedikit insight.
Perubahan terjadi ketika pendekatan digeser menjadi hanya fokus pada yang tidak normal.
Alih-alih bertanya “apa yang terjadi hari ini”, sistem mulai bertanya:
- Paket mana yang tidak bergerak?
- Proses mana yang terlalu lama?
- Alur mana yang tidak sesuai flow?
Pendekatan ini secara drastis mengurangi noise dan meningkatkan kecepatan respon. Bukan karena datanya berkurang, tapi karena perhatian menjadi lebih terarah.
Visibility Tidak Cukup Tanpa Mekanisme Tindakan
Memiliki dashboard sering kali memberi rasa aman. Semua terlihat, semua tercatat, dan semua bisa diakses kapan saja.
Namun dalam beberapa kasus, justru di sinilah masalahnya.
Sistem memberikan visibilitas, tapi tidak memberikan kejelasan tentang apa yang harus dilakukan ketika sesuatu terlihat tidak normal.
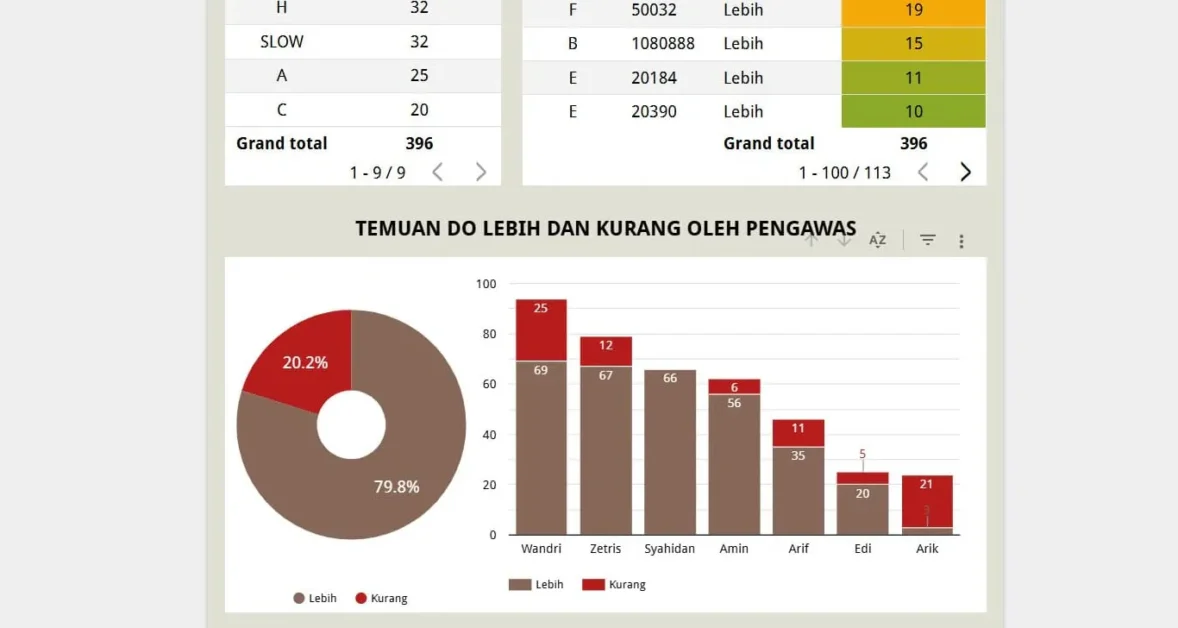
Dalam satu implementasi, dashboard sudah tersedia dengan cukup lengkap. Anomali sebenarnya terlihat, tetapi tidak ada kejelasan siapa yang harus bertindak dan bagaimana tindakan tersebut dilakukan.
Perubahan mulai terasa ketika setiap sinyal dihubungkan dengan tindakan “siapa yang bertanggung jawab, apa yang harus dilakukan, dan kapan harus dilakukan”.
Di titik itu, visibilitas mulai berubah menjadi kontrol.
Menuju Sistem yang Bisa Mendeteksi Masalahnya Sendiri
Level berikutnya dari system design bukan lagi tentang mencatat atau bahkan memonitor, tetapi tentang kemampuan sistem untuk mengenali pola yang tidak normal tanpa harus menunggu laporan.
Sistem yang matang tidak menunggu komplain, tidak menunggu audit, dan tidak bergantung sepenuhnya pada observasi manual.
Sistem harus mampu secara aktif untuk memenuhi beberapa hal berikut:
- Mengidentifikasi deviasi dari flow normal
- Memberi sinyal lebih awal
- Mendorong tindakan sebelum masalah membesar
Ini bukan soal teknologi yang kompleks. Dalam banyak kasus, pendekatan sederhana yang konsisten justru lebih efektif dibanding sistem yang canggih tapi tidak digunakan secara disiplin.
Sistem yang Baik Cepat Menyadari, Bukan Sekadar Mencegah
Tidak ada sistem yang benar-benar bebas dari risiko kehilangan.
Namun ada perbedaan besar antara sistem yang terlambat menyadari dan sistem yang mampu mengenali masalah sejak dini.
Dalam operasional skala besar, masalah hampir selalu dimulai dari hal kecil, yaitu delay yang dianggap wajar, gap yang tidak terlihat, atau deviasi yang tidak ditindaklanjuti.
System design yang baik tidak selalu fokus pada mencegah semua kemungkinan, tetapi pada memastikan bahwa setiap penyimpangan bisa terlihat dan ditangani secepat mungkin.
Karena pada akhirnya, bukan besar kecilnya masalah yang menentukan dampak, melainkan seberapa cepat kita menyadarinya.